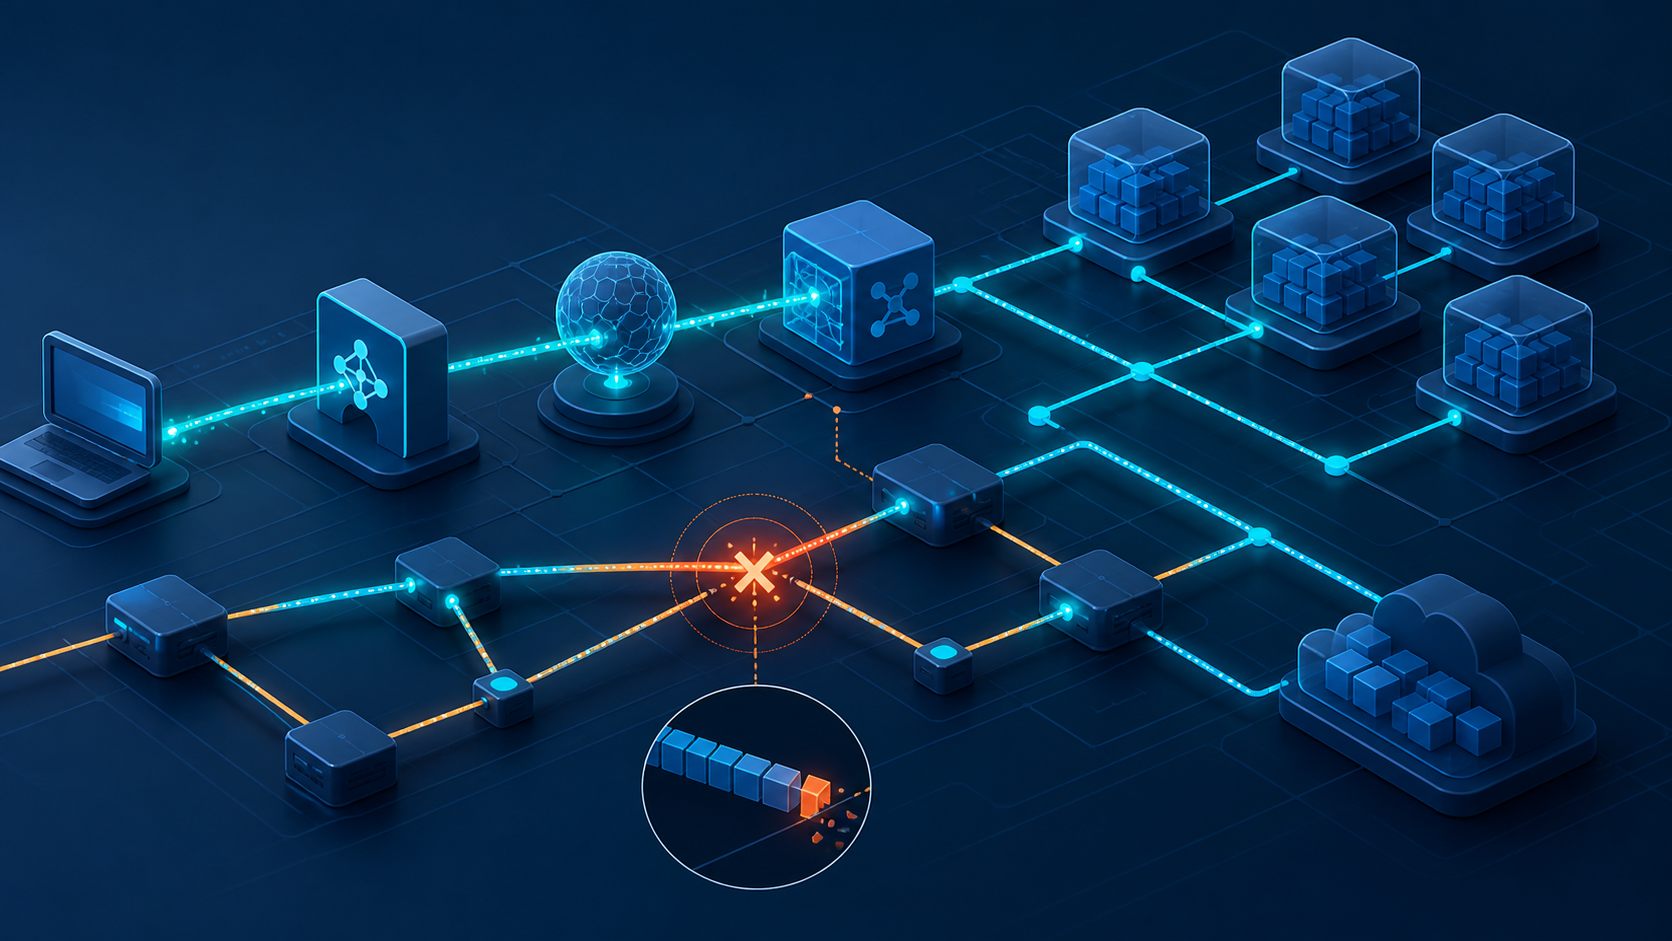
Service 偶发超时最难排查,因为 Pod 看起来正常,重试又可能成功。建议沿着“域名解析—Service 转发—Pod 网络—宿主机网络—应用监听”逐层缩小范围。
一、先固定故障边界
记录调用方 Pod、目标域名、Service、端口、协议、失败时间和比例。分别测试 Service 域名、ClusterIP、Pod IP 和同节点 Pod IP。
kubectl get svc,endpoints,endpointslices -A -o wide

kubectl run net-debug --rm -it --image=nicolaka/netshoot -- bash

dig +time=2 +tries=1 api.default.svc.cluster.local

curl -sv --connect-timeout 3 http://<cluster-ip>:<port>/health

curl -sv --connect-timeout 3 http://<pod-ip>:<port>/health
只有域名失败,重点看 CoreDNS;ClusterIP 失败但 Pod IP 正常,重点看 kube-proxy/IPVS;Pod IP 也失败,重点看 CNI、路由、策略和宿主机。
二、检查端点和就绪状态
确认 Service selector 是否选中正确 Pod,EndpointSlice 中是否存在过期地址,readinessProbe 是否频繁抖动。
kubectl describe svc <svc> -n <ns>

kubectl get endpointslice -n <ns> -l kubernetes.io/service-name=<svc> -o yaml

kubectl get pod -n <ns> -o wide

kubectl describe pod <pod> -n <ns>
如果滚动发布期间失败,检查 terminationGracePeriodSeconds、preStop、就绪探针和负载均衡摘除时序。
三、检查 CoreDNS
kubectl -n kube-system get pod -l k8s-app=kube-dns -o wide

kubectl -n kube-system logs -l k8s-app=kube-dns --tail=200

kubectl -n kube-system top pod -l k8s-app=kube-dns
关注超时、SERVFAIL、上游 DNS 不可达、缓存击穿和 CPU throttling。必要时临时扩容 CoreDNS,但扩容前应确认节点和网络没有共同故障。
四、检查 kube-proxy 与连接跟踪
iptables 模式检查规则是否存在;IPVS 模式检查虚拟服务和真实服务器。
iptables-save | grep <cluster-ip>

ipvsadm -Ln --stats

conntrack -S

sysctl net.netfilter.nf_conntrack_count net.netfilter.nf_conntrack_max
连接跟踪表接近上限、规则同步失败或 kube-proxy 反复重启,都会导致间歇性丢包。
五、检查 CNI、NetworkPolicy 与 MTU
查看 CNI Agent 日志、节点路由和接口错误。跨节点失败、同节点正常时尤其要检查隧道 MTU。
ip route

ip -s link

ping -M do -s 1400 <pod-ip>

tracepath <pod-ip>

kubectl get networkpolicy -A
如果小包正常、大响应超时,常见原因是 VXLAN/IPIP 封装后超过底层 MTU,而 ICMP 又被防火墙拦截。
六、止血和验证
先隔离异常节点、扩容健康副本、暂停发布,再针对故障层处理。修复后至少验证:DNS 连续解析、跨节点访问、长连接、滚动发布、峰值并发和大包传输,并持续观察 30 分钟错误率与重传率。
七、抓包与证据关联
只有常规命令无法定位时,再在调用方 Pod、目标节点和物理网卡同时短时抓包。使用同一个请求 ID 和时间戳关联应用日志、CoreDNS、kube-proxy/CNI 日志与数据包,判断请求究竟在哪一跳消失。
tcpdump -i any -nn host <目标IP> and port <PORT> -w /tmp/service-failure.pcap
kubectl get events -A --sort-by=.lastTimestamp | tail -50
抓包文件可能含业务数据,应限制时长、过滤目标并按敏感数据流程保存。
八、恢复检查清单
□ 已确认问题发生在 DNS、ClusterIP、Pod IP 还是应用监听
□ EndpointSlice 中只包含 Ready 且端口正确的后端
□ 同节点、跨节点、不同可用区均已验证
□ conntrack、kube-proxy/CNI 和节点资源没有持续异常
□ 小包、大包、短连接和长连接测试均通过
□ 修复后持续观察错误率、延迟、丢包和重传
总结
Service 间歇性失败要靠对照实验缩小范围:域名、ClusterIP、Pod IP、同节点和跨节点逐一比较,再将证据落到 DNS、端点、转发、CNI、MTU或应用。先隔离异常节点和保护业务,再进行有证据的修复。